人工智能 从概念到现实的全面解读
人工智能:从概念到现实的全面解读
人工智能(Artificial Intelligence,简称AI)并非一个单一的技术,而是一个涵盖多种方法和目标的庞大领域。它的核心追求,是让机器具备类似人类的感知、推理、学习和决策能力。从1956年达特茅斯会议上“人工智能”一词的正式提出,到今天大语言模型和生成式AI的爆发,这一领域经历了数次高潮与低谷,正深刻重塑人类社会。
一、什么是人工智能
从学术定义上看,人工智能是计算机科学的一个分支,致力于研究如何使计算机完成通常需要人类智能才能完成的任务。这些任务包括图像识别、语音理解、自然语言处理、博弈决策、路径规划等。按照能力层级,学界常将其划分为三类:弱人工智能(专注于特定任务,如人脸识别、推荐系统)、强人工智能(具备与人类相当的通用认知能力,目前尚未实现)以及超人工智能(在几乎所有领域超越人类的理论设想)。
当前我们日常接触到的一切AI应用,本质上都属于弱人工智能——它们在自己的任务范围内表现出色,但并不具备真正的通用理解力。
二、技术脉络:从规则到学习
人工智能的技术演进,大致可以概括为三条主线。
第一代是符号主义与专家系统。 早期研究者试图用逻辑规则和知识库来模拟人类推理,典型代表是20世纪七八十年代的专家系统。这类方法在封闭、规则清晰的问题上有效,但面对现实世界的模糊性和复杂性时,知识获取和规则维护的成本极高,逐渐遭遇瓶颈。
第二代是统计学习与机器学习。 随着数据量的增长和计算能力的提升,研究者转向让机器从数据中自动归纳规律。支持向量机、决策树、随机森林等算法在这一时期广泛应用。机器不再依赖人工编写规则,而是通过数据“学习”模式,泛化能力显著增强。
第三代是深度学习与大模型。 2012年AlexNet在图像识别竞赛中的突破,标志着深度学习时代的到来。多层神经网络借助GPU算力,在视觉、语音等领域全面超越传统方法。2017年Transformer架构的提出,则为大规模语言模型奠定了基础。此后,GPT系列、BERT等模型不断刷新能力边界,生成式AI开始进入公众视野。
值得强调的是,技术路线并非“后一代淘汰前一代”,而是叠加演进。今天的大模型背后,仍然大量依赖概率统计、优化理论和工程系统设计的积累。
三、当前的主要应用图景
人工智能的应用已渗透到多个关键领域,大致可以从以下几个方向观察:
- 语言与内容生成:大语言模型能够完成写作、翻译、摘要、代码生成等任务,成为知识工作者的辅助工具,同时也带来内容真实性核验的新挑战。
- 计算机视觉:从人脸识别、医疗影像辅助诊断到工业质检和自动驾驶感知,视觉技术是落地最成熟的AI方向之一。
- 推荐与决策系统:电商、内容平台和金融风控背后的推荐与预测系统,是AI在商业场景中大规模应用的典型代表。
- 科学与工程:在蛋白质结构预测、材料发现、气象预报等领域,AI正在成为科研范式的重要组成部分。
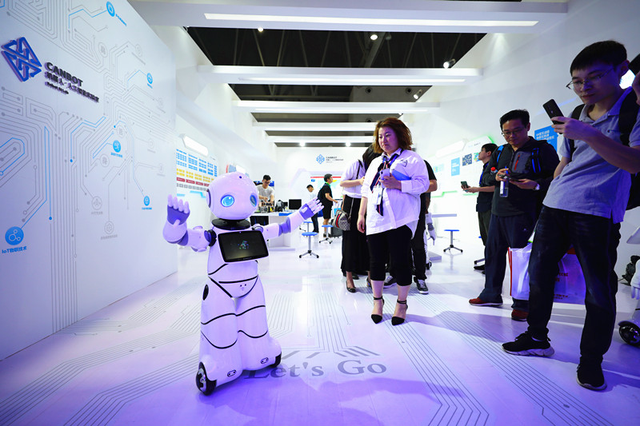
- 机器人与具身智能:将感知、规划与控制结合到物理实体中,是当前研究与产业的热点方向。
四、被反复讨论的难题
谈论人工智能,不能回避它带来的真实问题。
可解释性是其中一项基础性挑战。深度神经网络的决策过程往往如同黑箱,在高风险场景(如医疗、司法、信贷)中,仅给出结果而无法解释原因,会削弱信任并带来责任归属困难。
数据与偏见同样不容忽视。模型的能力来自训练数据,数据中的偏见会被学习并放大,可能导致对特定群体的不公平对待。数据隐私、版权和授权问题也随大模型的训练规模扩大而愈发突出。
幻觉与可靠性是大语言模型面临的现实痛点。生成式模型可能生成看似合理但事实错误的内容,在缺乏核验机制的场景中具有误导风险。
就业与社会结构方面,AI对重复性认知劳动的替代效应已经显现。历史经验表明技术变革会创造新岗位,但转型期的技能错配和分配不均需要制度层面的回应。
安全与治理则是宏观层面的议题。如何确保AI系统的行为符合人类意图、如何防止滥用、如何在创新与监管之间取得平衡,是各国政策制定者和研究者共同面对的课题。
五、走向何方
人工智能的发展可能沿着几条路径推进:一是多模态融合,让模型同时理解和生成文本、图像、音频与视频,更接近真实世界的感知方式;二是具身智能,让AI从数字空间走向物理世界,与机器人技术深度结合;三是效率与可持续性,在模型能力提升的同时降低算力消耗和能耗;四是可信AI,将安全性、公平性和可解释性作为系统设计的组成部分而非事后补丁。
归根结底,人工智能是人类智慧的延伸工具,而非替代品。它的价值取决于我们如何使用它、如何约束它、如何让技术进步惠及更广泛的人群。理解AI的能力边界与内在局限,比追逐每一次技术热点更为重要。
如若转载,请注明出处:http://www.huguangyue.com/product/33.html
更新时间:2026-11-01 01:35:56